Os grandes sistemas de inteligência artificial (IA) já sabem escrever textos escorreitos, resumir relatórios e resolver problemas matemáticos porque leram quase tudo o que estava disponível de graça na Internet. O desafio tecnológico passou agora a ser outro. Para ensinar um programa a tratar da contabilidade de uma empresa, a apoiar um diagnóstico clínico ou a guiar um robô na reparação de um motor, as páginas públicas da rede já não chegam.
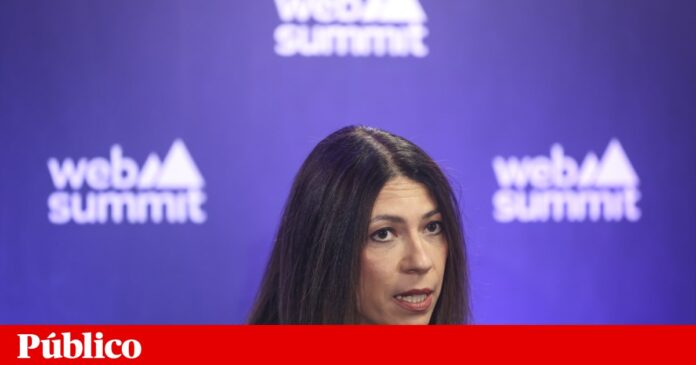
Foi a pensar nesta procura que Daniela Braga, fundadora e presidente executiva da Defined.ai, apresentou nesta terça-feira, em conferência de imprensa na Web Summit, em Lisboa, a nova versão alargada do marketplace (mercado digital) de dados da empresa. O catálogo reúne cerca de dez petabytes de informação, o equivalente a dez milhões de gigabytes, distribuídos por quase dois mil conjuntos de ficheiros de áudio, texto multilingue, imagem e vídeo, todos com origem identificada e direitos pagos.
Lançado originalmente em 2022 pela tecnológica fundada nos Estados Unidos por Daniela Braga, e que mantém em Lisboa o seu centro de investigação e desenvolvimento, este mercado digital cresceu ao ponto de representar já 70% das receitas da companhia. A empresária afirma fornecer dados aos principais laboratórios mundiais de IA, posicionando-se no pólo inverso ao de repositórios abertos e colaborativos como a conhecida plataforma Hugging Face. “Gosto de dizer que somos o oposto da Hugging Face, no sentido em que disponibilizamos dados humanos privados, obtidos com consentimento, totalmente anonimizados e pagos”, sublinhou.
Testar antes de comprar
Procurar matéria-prima num arquivo desta escala deixou também de exigir pesquisas complexas por filtros técnicos. A plataforma integra agora um assistente virtual próprio, construído sobre um grande modelo de linguagem semelhante ao que alimenta o ChatGPT, para ajudar os clientes a navegar no catálogo. Qualquer equipa pode descrever em linguagem corrente, e em qualquer idioma, o problema que pretende resolver para receber de imediato sugestões de pacotes compatíveis e descarregar amostras.
O acesso à montra faz-se através de um registo gratuito com endereço de correio electrónico. Segundo os números divulgados pela líder da Defined.ai, nas duas semanas que antecederam o anúncio oficial entraram no catálogo 280 empresas, num movimento que resultou em algumas centenas de novos registos, de transferências de amostras e de pedidos de orçamento.
Para reduzir a hesitação de quem receia investir avultadas quantias num conjunto de dados sem garantia de que o seu modelo inteligente vai efectivamente melhorar, a empresa estreou o programa anual denominado “strategic access program”. Em vez de comprarem pacotes avulso, os clientes adquirem créditos que dão acesso a todo o catálogo através de uma licença de investigação, fixada em 20% do valor comercial.
Só depois de treinarem e testarem os algoritmos, e caso comprovem ganhos reais de desempenho, é que avançam para a compra da licença comercial definitiva.
Dos hospitais às oficinas
A composição deste catálogo ajuda a perceber para onde caminha a indústria tecnológica e de que forma estas ferramentas vão entrar no dia-a-dia das pessoas. “Nesta área em que trabalho, se a cada três meses não estivermos a pensar na vaga seguinte, já estamos obsoletos”, gracejou Daniela Braga. Os vídeos genéricos, os podcasts ou as simples trocas de mensagens de texto perderam relevância comercial porque os modelos generalistas já dominam a escrita e o raciocínio básico.
A corrida faz-se agora na especialização profissional, com o objectivo declarado de treinar agentes autónomos capazes de executar tarefas completas nas empresas. A saúde assumiu um peso central nos investimentos da Defined.ai ao longo deste ano, abrangendo desde exames radiológicos e análises clínicas até históricos de acompanhamento de doentes, medicina dentária, diálogos entre médicos e pacientes ou transcrições de consultas de psiquiatria recolhidas em diferentes regiões do globo, onde os protocolos clínicos variam.
Ao mesmo tempo, disparou a procura pelos chamados dados de produtividade, que incluem comunicações internas por correio electrónico, contratos, regras de recursos humanos, auditorias financeiras e actas de conselhos de administração, sempre limpos de qualquer identificação pessoal.
A outra frente de crescimento atende pelo nome de IA física, expressão usada para descrever os cérebros digitais que vão dar corpo a robôs no mundo real. “O mercado já não pede dados de pessoas com uma câmara na cabeça a dobrar roupa. Já passámos essa fase há bastante tempo”, apontou a executiva.
Quem já perdeu uma tarde de sábado a tentar decifrar um esquema de bricolage perceberá a dimensão do salto técnico. Os laboratórios pedem hoje gravações de pessoas a montar móveis, a arranjar automóveis, a fazer reparações eléctricas domésticas ou mesmo a executar cirurgias. E já não basta filmar a partir da testa, sendo necessário captar movimentos em três dimensões com sensores distribuídos pelas mãos, pelo peito e pelo resto do corpo.
Triagem com supervisão humana
Como nenhuma empresa consegue produzir sozinha semelhante variedade de registos, a terceira novidade apresentada na Web Summit passa pelo “partner acceleration program”, um programa destinado a acelerar a entrada de parceiros que tenham arquivos internos parados e queiram rentabilizá-los.
A tecnológica utiliza ferramentas de IA para abreviar as verificações jurídicas e de cibersegurança às empresas fornecedoras, garantindo o cumprimento de normas internacionais e de regras como o Regulamento Geral sobre a Protecção de Dados (RGPD) europeu. “Nada é recolhido de forma abusiva na Internet”, assegurou Daniela Braga, rejeitando trabalhar com conteúdos ditos gratuitos da rede.
Questionada pelo PÚBLICO sobre o modo como uma equipa relativamente pequena consegue gerir, avaliar e atribuir valor comercial a dados de áreas tão díspares, a presidente da Defined.ai explicou que a triagem combina automação com o crivo de especialistas humanos.
Sempre que surge uma oportunidade de negócio junto de um cliente, a plataforma dispara automaticamente um pedido de propostas aos parceiros qualificados, até porque, como notou, “o tempo mata todos os negócios”. Já a validação inicial das dezenas de candidaturas diárias continua entregue a pessoas e barra à partida quem tente apresentar-se a título individual, exigindo uma empresa formalmente constituída.
Pedir licença ou pedir desculpa
A estratégia da Defined.ai esbarra, ainda assim, nas oscilações políticas e regulatórias do mercado global. Daniela Braga lembrou que, após a aplicação do RGPD na União Europeia, cresceu a consciência sobre a proveniência legal da informação. Esse cuidado sofreu um revés entre 2023 e 2024, logo a seguir à explosão do ChatGPT, quando parte do sector tecnológico preferiu recolher dados de qualquer maneira para “pedir desculpa em vez de pedir licença”.
A onda de processos judiciais movidos por detentores de direitos de autor obrigou, entretanto, várias entidades a travar a fundo e a auditar a origem dos ficheiros usados nos treinos. Embora reconheça um ligeiro abrandamento nas exigências éticas durante o último ano, à boleia do actual ambiente de desregulação nos Estados Unidos, a investigadora portuguesa vê nestes recuos um movimento passageiro num sector que acompanha há 26 anos.
Quando os algoritmos saem dos ecrãs de conversação para entrar nos blocos operatórios, nas linhas de montagem e na gestão das empresas, saber de onde vêm os dados pesa tanto na reputação de uma marca como aquilo que a máquina é capaz de fazer.
Disclaimer : This story is auto aggregated by a computer programme and has not been created or edited by DOWNTHENEWS. Publisher: feeds.feedburner.com